- عرضه Tether برای اولین بار از ماه مه 2022 برای اولین بار از 80B دلار برخورد می کند - رقبای Stablecoin Stumble
- تحلیلگران وقتی بانک خود را تحت عنوان IPO قرار نمی دهند ، سهام بهتری می گیرند.
- معاملات در فرایندها
- "شکستن بلوک ها: راهنمای ضروری برای نشانه های اهرمی Binance"
- Bubblemaps 10 ٪ از کیف پول های Shiba Token به ارزش بیش از 1 میلیارد دلار را تجزیه و تحلیل می کند
- درباره Leea
- چشم انداز فنی هفتگی: Momentum در طلا (XAU/USD) ، GBP/NZD و CAD/JPY بازی می کند
- چگونه مبادلات رمزنگاری درآمد کسب می کند؟یک راهنمای کوتاه برای سرمایه گذاران بالقوه
- برنامه نویسی متاتریدر 4 (MT4) چگونه کار می کند؟
- انجمن QuantCoect
آخرین مطالب
امکانات وب


ESTMDL = برآورد (MDL ، Y) پارامترهای مدل ARIMA (P ، D ، Q) MDL را با توجه به سری زمانی یک متغیره مشاهده شده Y با استفاده از حداکثر احتمال ، برآورد می کند. ESTMDL مدل ARIMA کاملاً مشخص است که تخمین پارامتر را ذخیره می کند.
ESTMDL = برآورد (MDL ، Y ، نام ، مقدار) از گزینه های اضافی که توسط یک یا چند آرگومان ارزش نام مشخص شده است استفاده می کند. به عنوان مثال ، "x" ، X شامل یک مؤلفه رگرسیون خطی در مدل برای داده های برونزا در x است.
[ESTMDL ، ESTPARAMCOV ، LOGL ، INFO] = برآورد (___) همچنین ماتریس واریانس کواریانس مرتبط با پارامترهای تخمین زده شده ESTPARAMCOV ، ورود بهینه شده به نظر می رسد LoglikeLICHITIVE LOGL و اطلاعات خلاصه اطلاعات را با استفاده از هر یک از ترکیبات ورودی در قسمت قبلی بازگرداند. نحو
مثال ها
مدل ARMA را تخمین بزنید
یک مدل ARMA (2،1) را برای داده های شبیه سازی شده قرار دهید.
داده ها را از مدل شناخته شده شبیه سازی کنید
فرض کنید فرآیند تولید داده (DGP) است
y t = 0. 5 y t - 1 - 0. 3 y t - 2 + ε t + 0. 2 ε t - 1 ،
جایی که ε t یک سری از متغیرهای تصادفی IID گاوسی با میانگین 0 و واریانس 0. 1 است.
مدل ARMA (2،1) را به نمایندگی از DGP ایجاد کنید.
DGP یک شیء مدل ARIMA کاملاً مشخص است.
یک مسیر مشاهده تصادفی 500 را از مدل ARMA (2،1) شبیه سازی کنید.
y یک بردار ستون 500 به 1 است که یک مسیر پاسخ شبیه سازی شده از مدل ARMA (2،1) DGP را نشان می دهد.
مدل تخمین
برای تخمین یک الگوی مدل ARMA (2،1) ایجاد کنید.
MDL یک شیء مدل ARIMA تا حدی مشخص شده است. فقط پارامترهای غیر قابل ارزیابی که ساختار مدل را تعیین می کنند ، مشخص شده اند. خواص با ارزش NAN ، از جمله 1 ، 2 ، θ 1 ، C و σ 2 ، پارامترهای مدل ناشناخته ای هستند که باید تخمین زده شود.
مدل ARMA (2،1) را در y قرار دهید.
MATLAB® یک جدول حاوی خلاصه تخمین را نشان می دهد ، که شامل برآورد پارامتر و استنتاج است. به عنوان مثال ، ستون مقدار حاوی برآورد حداکثر احتمال مربوط به احتمال است ، و ستون PValue حاوی مقادیر p برای آزمون t بدون علامت از فرضیه تهی است که پارامتر مربوطه 0 است.
ESTMDL یک شیء مدل ARIMA کاملاً مشخص و تخمین زده شده است. برآوردهای آن شبیه به مقادیر پارامتر DGP است.
در طول تخمین محدودیت های برابری را برای پارامترها اعمال کنید
یک مدل AR (2) را برای داده های شبیه سازی شده در حین نگه داشتن مدل ثابت در طول تخمین قرار دهید.
داده ها را از مدل شناخته شده شبیه سازی کنید
فرض کنید DGP است
y t = 0. 5 y t - 1 - 0. 3 y t - 2 + ε t ،
جایی که ε t یک سری از متغیرهای تصادفی IID گاوسی با میانگین 0 و واریانس 0. 1 است.
مدل AR (2) را نشان دهید که DGP را نشان می دهد.
یک مسیر مشاهده تصادفی 500 را از مدل شبیه سازی کنید.
ایجاد شیء مدل محدودیت را ایجاد کنید
فرض کنید که میانگین y t 0 است ، که دلالت بر این دارد که C 0 است.
برای تخمین یک مدل AR (2) ایجاد کنید. C را روی 0 تنظیم کنید.
MDL یک شیء مدل ARIMA تا حدی مشخص شده است. پارامترهای مشخص شده شامل کلیه پارامترهای مورد نیاز و ثابت مدل است. خواص با ارزش NAN ، از جمله 1 ، 2 ، 2 و σ 2 ، پارامترهای مدل ناشناخته ای هستند که باید تخمین زده شوند.
مدل تخمین
متناسب با الگوی مدل AR (2) که حاوی محدودیت در y است.
ESTMDL یک شیء مدل ARIMA کاملاً مشخص و تخمین زده شده است. برآوردهای آن شبیه به مقادیر پارامتر مدل AR (2) DGP است. مقدار C در خلاصه تخمین و نمایش شی 0 است و استنتاج های مربوطه بی اهمیت هستند یا کاربردی ندارند.
تخمین مدل را با استفاده از داده های پاسخ presample اولیه کنید
از آنجا که یک مدل ARIMA تابعی از مقادیر قبلی است ، برآورد نیاز به داده های پیش فرض دارد تا مدل را در اوایل دوره نمونه برداری اولیه کند. اگرچه ، Backcasts را برای داده های نمونه به طور پیش فرض تخمین بزنید ، می توانید به جای آن داده های مورد نیاز را مشخص کنید. خاصیت P یک شیء مدل ARIMA تعداد مورد نیاز مشاهدات نمونه را مشخص می کند.
مجموعه داده های شاخص سهام ایالات متحده Data_EquityIdx را بارگیری کنید.
جدول DataTable شامل متغیر سری زمانی NYSE است که حاوی قیمت بسته شدن کامپوزیت روزانه NYSE از ژانویه 1990 تا دسامبر 1995 است.
جدول را به یک جدول زمانی تبدیل کنید.
الگوی مدل ایجاد کنید
فرض کنید که یک مدل ARIMA (1،1،1) برای مدل سازی سری کامپوزیت NYSE در طول نمونه مناسب است.
برای تخمین یک الگوی مدل ARIMA (1،1،1) ایجاد کنید.
MDL یک شیء مدل ARIMA تا حدی مشخص شده است.
نمونه پارتیشن
بردارهای شاخص هایی را ایجاد کنید که نمونه را به دوره های نمونه و تخمین تقسیم می کنند ، به طوری که نمونه اول اتفاق می افتد و حاوی مشاهدات MDL. P = 2 است و نمونه تخمین شامل مشاهدات باقی مانده است.
مدل تخمین
یک مدل ARIMA (1،1،1) را در نمونه تخمین قرار دهید. پاسخ های نمونه را مشخص کنید.
ESTMDL یک شیء مدل ARIMA کاملاً مشخص و تخمین زده شده است.
مقادیر پارامتر اولیه را برای بهینه سازی مشخص کنید
یک مدل ARIMA (1،1،1) را در نزدیکی روزانه شاخص کامپوزیت NYSE قرار دهید. مقادیر پارامتر اولیه به دست آمده از تجزیه و تحلیل یک نمونه آزمایشی را مشخص کنید.
مجموعه داده های شاخص سهام ایالات متحده Data_EquityIdx را بارگیری کنید.
جدول DataTable شامل متغیر سری زمانی NYSE است که حاوی قیمت بسته شدن کامپوزیت روزانه NYSE از ژانویه 1990 تا دسامبر 1995 است.
جدول را به یک جدول زمانی تبدیل کنید.
مدل مناسب برای نمونه آزمایشی
فرض کنید که یک مدل ARIMA (1،1،1) برای مدل سازی سری کامپوزیت NYSE در طول نمونه مناسب است.
برای تخمین یک الگوی مدل ARIMA (1،1،1) ایجاد کنید.
MDL یک شیء مدل ARIMA تا حدی مشخص شده است.
دو سال اول را به عنوان نمونه آزمایشی برای به دست آوردن مقادیر پارامتر اولیه هنگام قرار دادن مدل در سه سال باقی مانده از داده ها درمان کنید. مدل را با نمونه آزمایشی قرار دهید.
ESTMDL0 یک شیء مدل ARIMA کاملاً مشخص و تخمین زده شده است.
مدل تخمین
یک مدل ARIMA (1،1،1) را در نمونه تخمین قرار دهید. پارامترهای تخمین زده شده را از نمونه آزمایشی به عنوان مقادیر اولیه برای بهینه سازی مشخص کنید.
ESTMDL یک شیء مدل ARIMA کاملاً مشخص و تخمین زده شده است.
تخمین مدل ARIMA حاوی پیش بینی کننده های اگزوژن (ARIMAX)
یک مدل ARIMAX را در داده های شبیه سازی شده سری قرار دهید.
داده های پیش بینی کننده و پاسخ را شبیه سازی کنید
مدل Arimax (2،1،0) را برای DGP ایجاد کنید ، که توسط Y T در معادله نشان داده شده است
(1 - 0. 5 l + 0. 3 l 2) (1 - l) 1 y t = 2 + 1. 5 x 1 ، t + 2. 6 x 2 ، t - 0. 3 x 3 ، t + ε t ،
جایی که ε t یک سری از متغیرهای تصادفی IID گاوسی با میانگین 0 و واریانس 0. 1 است.
فرض کنید متغیرهای اگزوژن X 1 ، T ، X 2 ، T و X 3 ، T توسط فرآیندهای AR (1) نشان داده شده اند
x 1 ، t = 0. 1 x 1 ، t - 1 + η 1 ، t x 2 ، t = 0. 2 x 2 ، t - 1 + η 2 ، t x 3 ، t = 0. 3 x 3 ، t - 1 + η 3 ، t ،
جایی که η i ، t از توزیع گاوسی با میانگین 0 و واریانس 0. 01 برای i ∈<1 , 2 , 3>وادمدل های ARIMA را ایجاد کنید که متغیرهای اگزوژن را نشان می دهد.
طول 1000 سری اگزوژن را از مدل های AR شبیه سازی کنید. داده های شبیه سازی شده را در یک ماتریس ذخیره کنید.
X یک ماتریس 1000 در 3 از داده های سری شبیه سازی شده است. هر سطر با یک مشاهده در سری زمانی مطابقت دارد ، و هر ستون با یک متغیر اگزوژن مطابقت دارد.
یک سری طول 1000 را از DGP شبیه سازی کنید. داده های اگزوژن شبیه سازی شده را مشخص کنید.
y یک بردار 1000 به 1 از داده های پاسخ است.
مدل تخمین
برای تخمین یک الگوی مدل ARIMA (2،1،0) ایجاد کنید.
توضیحات مدل (خاصیت توضیحات) و ارزش بتا نشان می دهد که شیء مدل ARIMA که تا حدی مشخص شده است ، آگنوستیک پیش بینی کننده های برون زا است.
مدل ARIMAX (2،1،0) را تخمین بزنید. داده های پیش بینی کننده اگزوژن را مشخص کنید. از آنجا که Backcasts را برای پاسخ های نمونه تخمین می زند (فرآیندی که به داده های پیش بینی کننده برای مدل های ARIMAX نیاز دارد) ، مدل را با آخرین پاسخ های T - MDL. P قرار دهید.(از طرف دیگر ، می توانید با استفاده از آرگومان جفت ارزش نام "Y0" ، پاسخ های predample را مشخص کنید.)
ESTMDL یک شیء مدل ARIMA کاملاً مشخص و تخمین زده شده است.
هنگامی که مدل را با استفاده از برآورد و تهیه داده های برونزا با مشخص کردن آرگومان جفت ارزش "X" تخمین می زنید ، MATLAB® مدل را به عنوان یک مدل ARIMAX (2،1،0) تشخیص می دهد و شامل یک جزء رگرسیون خطی برای اگزوژن است. متغیرها
مدل تخمین زده شده است
(1 - 0. 56 L + 0. 27 L 2) (1 - l) 1 y t = 1. 75 + 1. 48 x 1 ، t + 2. 56 x 2 ، t - 0. 34 x 3 ، t + ε t ،
که شبیه DGP است که توسط MDL0 نشان داده شده است. از آنجا که MATLAB ضرایب AR مدل بیان شده در نماد اختلاف را باز می گرداند ، علائم آنها در معادله مخالف است.
خطاهای استاندارد تخمین زده شده را محاسبه کنید
مجموعه داده های شاخص سهام ایالات متحده Data_EquityIdx را بارگیری کنید.
جدول DataTable شامل متغیر سری زمانی NYSE است که حاوی قیمت بسته شدن کامپوزیت روزانه NYSE از ژانویه 1990 تا دسامبر 1995 است.
جدول را به یک جدول زمانی تبدیل کنید.
فرض کنید که یک مدل ARIMA (1،1،1) برای مدل سازی سری Composite NYSE در دوره نمونه مناسب است
یک مدل ARIMA (1،1،1) را به داده ها متناسب کنید و ماتریس کواریانس پارامتر تخمین زده شده را برگردانید.
ESTMDL یک شیء مدل ARIMA کاملاً مشخص و تخمین زده شده است. ردیف ها و ستون های Estparamcov با ردیف های موجود در جدول تخمین ها و استنتاج ها مطابقت دارند. به عنوان مثال ، c o v ˆ (ϕ ˆ 1 ، θ ˆ 1) = - 0. 0 2 4.
با استفاده از ریشه مربع عناصر مورب ماتریس کواریانس ، خطاهای استاندارد پارامتر تخمین زده شده را محاسبه کنید.
یک فاصله اطمینان 95 ٪ مبتنی بر والد را در ϕ محاسبه کنید.
فاصله حاوی 0 است ، که نشان می دهد ϕ ناچیز است.
مقادیر پاسخ متناسب را محاسبه کنید
مجموعه داده های شاخص سهام ایالات متحده Data_EquityIdx را بارگیری کنید.
جدول DataTable شامل متغیر سری زمانی NYSE است که حاوی قیمت بسته شدن کامپوزیت روزانه NYSE از ژانویه 1990 تا دسامبر 1995 است.
جدول را به یک جدول زمانی تبدیل کنید.
فرض کنید که یک مدل ARIMA (1،1،1) برای مدل سازی سری کامپوزیت NYSE در طول نمونه مناسب است.
یک مدل ARIMA (1،1،1) را با داده ها قرار دهید. نمونه مورد نیاز را مشخص کرده و صفحه تخمین را خاموش کنید.
باقیمانده های استنباط ε t ˆ از مدل تخمین زده شده ، نمونه مورد نیاز را مشخص کنید.
باقیمانده یک بردار (t-mdl. p) -by-1 باقیمانده است.
مقادیر متناسب y t را محاسبه کنید.
مشاهدات و مقادیر مناسب را در همان نمودار ترسیم کنید.
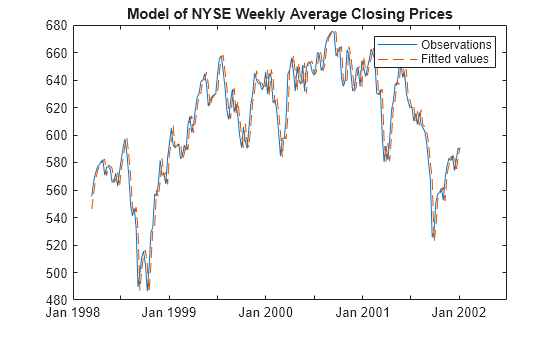
مقادیر متناسب مشاهدات را از نزدیک ردیابی می کنند.
باقیمانده ها را در مقابل مقادیر مناسب ترسیم کنید.
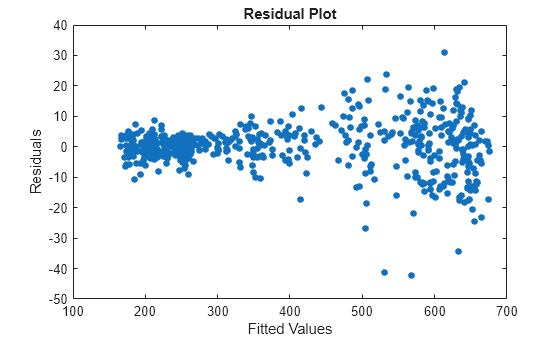
واریانس باقیمانده برای مقادیر متناسب بزرگتر به نظر می رسد. یکی از راه حل های این رفتار استفاده از تبدیل log در داده ها است.
استدلال های ورودی
MDL - مدل ARIMA مدل ARIMA که تا حدی مشخص شده است
مدل ARIMA تا حدی مشخص شده برای نشان دادن پارامترهای مدل محدود و برآورد شده ، که به عنوان یک شیء مدل ARIMA که توسط ARIMA یا تخمین برگشته است ، مشخص شده است. خواص MDL ساختار مدل را شرح داده و پارامترها را مشخص می کند.
برآورد پارامترهای نامشخص (NA N-با ارزش) به داده y متناسب است.
برآورد پارامترهای مشخص شده را به عنوان محدودیت برابری در طول تخمین درمان می کند.
y - یک مسیر واحد از داده های پاسخ وکتور ستون عددی
مسیر واحد داده های پاسخ که MDL مدل متناسب است ، به عنوان یک بردار ستون عددی مشخص شده است. آخرین مشاهده y آخرین مشاهده است.
انواع داده ها: دو برابر
استدلال های ارزش نام
جفت آرگومان های اختیاری را به عنوان name1 = value1 مشخص کنید. namen = valuen ، که در آن نام نام و مقدار آرگومان است مقدار مربوطه است. آرگومان های ارزش نام باید پس از سایر استدلال ها ظاهر شوند ، اما ترتیب جفت ها اهمیتی ندارند.
قبل از R2021A ، از کاما برای جدا کردن هر نام و مقدار استفاده کنید و نام را در نقل قول ها محصور کنید.
مثال: 'Y0' ، Y0 ، 'X' ، x از بردار Y0 به عنوان پاسخ های نمونه مورد نیاز برای تخمین استفاده می کند ، و شامل یک مؤلفه رگرسیون خطی برای داده های پیش بینی کننده اگزوژن در x است.
X - ماتریس داده پیش بینی کننده اگزوژن
داده های پیش بینی کننده اگزوژن برای مؤلفه رگرسیون خطی ، به عنوان جفت جدا از کاما متشکل از "X" و یک ماتریس مشخص شده است.
ستون های X سری زمانی جداگانه و هماهنگ هستند. ردیف آخر شامل آخرین مشاهدات است.
اگر داده های پاسخ presample را با استفاده از آرگومان جفت ارزش "Y0" مشخص نکنید ، تعداد ردیف های X باید حداقل Numel (Y) + MDL. P باشد. در غیر این صورت ، تعداد ردیف های X باید حداقل طول y باشد.
اگر تعداد ردیف های X از تعداد مورد نیاز فراتر رود ، تخمین فقط از آخرین مشاهدات استفاده می کند.
تخمین X و Y را هماهنگ می کند تا آخرین مشاهدات (آخرین ردیف ها) به طور همزمان اتفاق بیفتد.
به طور پیش فرض ، برآورد ضرایب رگرسیون را صرف نظر از حضور آنها در MDL تخمین نمی زند.
انواع داده ها: دو برابر
گزینه ها - گزینه های بهینه سازی بهینه سازی بهینه سازی کنترلر
گزینه های بهینه سازی ، به عنوان جفت جدا از کاما متشکل از "گزینه ها" و یک کنترلر بهینه سازی بهینه سازی مشخص شده است. برای جزئیات بیشتر در مورد اصلاح مقادیر پیش فرض بهینه ساز ، به OptimOptions یا FMINCON در جعبه ابزار بهینه سازی مراجعه کنید.
به عنوان مثال ، برای تغییر تحمل محدودیت به 1E-6 ، گزینه ها = OptimOptions (@fmincon ، "ConstraintTolerance" ، 1E-6 ، "الگوریتم" ، "SQP") را تنظیم کنید. سپس ، گزینه ها را با استفاده از گزینه های "گزینه ها" ، به تخمین برسانید.
به طور پیش فرض ، برآورد از گزینه های پیش فرض مشابه Fmincon استفاده می کند ، به جز الگوریتم "SQP" است و Constrainttolarance 1E-7 است.
نمایش - گزینه نمایش پنجره فرمان "پارامترها" (پیش فرض) |"تشخیص" |"کامل" |'iter' |'خاموش' |رشته رشته |بردار سلول بردارهای کاراکتر
گزینه نمایش پنجره فرمان ، به عنوان جفت جدا از کاما متشکل از "نمایش" و یک یا چند مقادیر موجود در این جدول مشخص شده است.
| ارزش | اطلاعات نمایش داده شده |
|---|---|
| "تشخیص" | تشخیص بهینه سازی |
| 'پر شده' | حداکثر تخمین پارامتر احتمال ، خطاهای استاندارد ، آمار T ، اطلاعات بهینه سازی تکراری و تشخیص بهینه سازی |
| "تکرار" | اطلاعات بهینه سازی تکراری |
| "خاموش" | هیچ یک |
| "پارامس" | حداکثر تخمین پارامتر احتمال ، خطاهای استاندارد و آمار t |
مثال: "نمایش" ، "خاموش" برای اجرای شبیه سازی مناسب است که بسیاری از مدل ها را تخمین می زند.
مثال: "نمایش" ، تمام نتایج تخمین و تشخیص بهینه سازی را نشان می دهد.
انواع داده ها: char |سلول |رشته
y0 - وکتور ستون عددی داده پاسخ نمونه
داده های پاسخ presample برای اولیه سازی مدل ، به عنوان جفت جدا از کاما متشکل از "Y0" و یک بردار ستون عددی مشخص شده است.
طول Y0 باید حداقل mdl. p باشد. اگر Y0 دارای ردیف های اضافی باشد ، تخمین فقط از آخرین پاسخهای MDL. P استفاده می کند. ردیف آخر حاوی آخرین پاسخ های نمونه است.
به طور پیش فرض ، پیش بینی های عقب مانده (backcasts) را برای مقدار لازم پاسخ های نمونه ای تخمین بزنید.
برای جزئیات بیشتر در مورد داده های پارتیشن بندی برای تخمین ، به پارتیشن های پایه زمان برای برآورد مدل ARIMA مراجعه کنید.
انواع داده ها: دو برابر
E0 - وکتور ستون عددی نوآوری ها را نمونه برداری کنید
نوآوری های Presample εحرفبرای اولیه سازی مدل ، به عنوان جفت جدا از کاما متشکل از "E0" و یک بردار ستون عددی مشخص شده است.
طول E0 باید حداقل mdl. q باشد. اگر E0 دارای ردیف های اضافی است ، تخمین فقط از آخرین نوآوری های MDL. Q Presample استفاده می کند. ردیف آخر شامل جدیدترین نوآوری Presample است.
اگر MDL. Variance یک شیء مدل واریانس شرطی باشد ، مانند مدل GARCH ، تخمین می تواند به نوآوری های نمونه MDL. Q نیاز داشته باشد.
به طور پیش فرض ، تخمین تمام نوآوری های مورد نیاز را به 0 تنظیم می کند ، که میانگین آنهاست.
انواع داده ها: دو برابر
v0 - نمونه واریانس شرطی وکتور ستون مثبت عددی
واریانس های شرطی Presample σ 2حرفبرای اولیه سازی هر مدل واریانس شرطی ، به عنوان جفت جدا از کاما متشکل از "V0" و یک بردار ستون مثبت عددی مشخص شده است.
طول V0 باید حداقل تعداد مشاهدات مورد نیاز برای اولیه سازی مدل واریانس شرطی باشد (تخمین را ببینید). اگر V0 دارای ردیف های اضافی باشد ، تخمین فقط از آخرین مشاهدات استفاده می کند. ردیف آخر شامل آخرین مشاهدات است.
اگر واریانس ثابت است ، تخمین V0 را نادیده بگیرید.
به طور پیش فرض ، برآورد ، واریانس شرطی پیش بینی لازم را به میانگین نوآوری های استنباط شده مربع تعیین می کند.
انواع داده ها: دو برابر
ثابت 0 - برآورد اولیه مقیاس عددی ثابت مدل
برآورد اولیه مدل C ثابت ، به عنوان جفت جدا از کاما متشکل از "ثابت 0" و یک مقیاس عددی مشخص شده است.
به طور پیش فرض ، برآورد تخمین های اولیه را با استفاده از تکنیک های سری زمانی استاندارد استخراج می کند.
انواع داده ها: دو برابر
AR0 - برآوردهای اولیه از ضرایب چند جمله ای AR غیر فصلی بردار عددی
برآوردهای اولیه از ضرایب چند جمله ای AR غیر فصل ϕ (L) ، که به عنوان جفت جدا از کاما متشکل از "AR0" و یک بردار عددی مشخص شده است.
طول AR0 باید با تعداد تاخیر مرتبط با ضرایب غیرزرو در چند جمله ای غیر فصلی AR برابر باشد. عناصر AR0 با عناصر MDL. AR مطابقت دارد.
به طور پیش فرض ، برآورد تخمین های اولیه را با استفاده از تکنیک های سری زمانی استاندارد استخراج می کند.
انواع داده ها: دو برابر
SAR0 - برآوردهای اولیه از ضرایب چند جمله ای اتورگرایی فصلی بردار عددی
برآوردهای اولیه از ضرایب چند جمله ای اتورگرایی فصلی φ (L) ، که به عنوان جفت جدا از کاما متشکل از "SAR0" و یک بردار عددی مشخص شده است.
طول SAR0 باید با تعداد تاخیر مرتبط با ضرایب غیرزرو در سارلاگ های چند جمله ای خودجوش فصلی برابر باشد. عناصر SAR0 با عناصر MDL. SAR مطابقت دارد.
به طور پیش فرض ، برآورد تخمین های اولیه را با استفاده از تکنیک های سری زمانی استاندارد استخراج می کند.
انواع داده ها: دو برابر
MA0 - برآوردهای اولیه از حرکات چند جمله ای متوسط در حال حرکت غیر منطقی وکتور عددی
برآوردهای اولیه از ضرایب چند جمله ای متوسط در حال حرکت غیر منطقی θ (L) ، که به عنوان جفت جدا از کاما متشکل از "MA0" و یک بردار عددی مشخص شده است.
طول MA0 باید با تعداد تاخیر مرتبط با ضرایب غیرزرو در مالاگهای چند جملهای متوسط در حال حرکت غیر منطقی برابر باشد. عناصر MA0 با عناصر mdl. ma مطابقت دارد.
به طور پیش فرض ، برآورد تخمین های اولیه را با استفاده از تکنیک های سری زمانی استاندارد استخراج می کند.
انواع داده ها: دو برابر
SMA0 - برآوردهای اولیه از ضرایب چند جمله ای متوسط حرکت فصلی وکتور عددی
برآوردهای اولیه ضرایب چند جمله ای متوسط حرکت فصلی θ (L) ، که به عنوان جفت جدا از کاما متشکل از "SMA0" و یک بردار عددی مشخص شده است.
طول SMA0 باید با تعداد تاخیر مرتبط با ضرایب Nonzero در SMALAG های چند جملهای متوسط حرکت فصلی برابر باشد. عناصر SMA0 با عناصر mdl. sma مطابقت دارد.
به طور پیش فرض ، برآورد تخمین های اولیه را با استفاده از تکنیک های سری زمانی استاندارد استخراج می کند.
انواع داده ها: دو برابر
Beta0 - برآوردهای اولیه از ضرایب رگرسیون بردار عددی
برآوردهای اولیه ضرایب رگرسیون β ، به عنوان جفت جدا از کاما متشکل از "بتا0" و یک بردار عددی مشخص شده است.
طول Beta0 باید با تعداد ستون های x برابر باشد. عناصر Beta0 با متغیرهای پیش بینی کننده نشان داده شده توسط ستون های X مطابقت دارد.
به طور پیش فرض ، برآورد تخمین های اولیه را با استفاده از تکنیک های سری زمانی استاندارد استخراج می کند.
انواع داده ها: دو برابر
DOF0-برآورد اولیه از درجه T-Distribution پارامتر 10 (پیش فرض) |مقیاس پذیر
برآورد اولیه از درجه T- توزیع پارامتر از آزادی ν ، به عنوان جفت جدا از کاما متشکل از "DOF0" و یک مقیاس مثبت مشخص شده است. DOF0 باید بیش از 2 باشد.
انواع داده ها: دو برابر
واریانس 0 - برآوردهای اولیه واریانس نوآوری های مقیاس مثبت |وکتور سلولی آرگومان های جفت ارزش نام
برآوردهای اولیه واریانس نوآوری ها ، به عنوان جفت جدا از کاما متشکل از "واریانس 0" و یک مقیاس مثبت یا یک بردار سلول از آرگومان های جفت ارزش نام مشخص شده است.
| ارزش mdl. variance | شرح | مقدار "واریانس 0" |
|---|---|---|
| مقیاس عددی یا نان | واریانس ثابت | مقیاس پذیر |
| Garch ، Egarch یا Object Model GJR | مدل واریانس مشروط | وکتور سلولی آرگومان های جفت ارزش نام برای مشخص کردن برآوردهای اولیه ، به عملکرد تخمین اشیاء مدل واریانس شرطی مراجعه کنید |
به طور پیش فرض ، برآورد تخمین های اولیه را با استفاده از تکنیک های سری زمانی استاندارد استخراج می کند.
مثال: برای یک مدل با واریانس ثابت ، "واریانس 0" ، 2 را تنظیم کنید تا یک برآورد واریانس اولیه 2 را مشخص کنید.
مثال: برای یک مدل میانگین و واریانس شرطی کامپوزیت ، "واریانس 0" را تنظیم کنید تا یک تخمین اولیه از 2 را برای ثابت مدل واریانس شرطی مشخص کنید ، و یک تخمین اولیه از 0. 1 برای ضریب تاخیر 1 در چند جمله ای قوس.
انواع داده ها: دو برابر |سلول
توجه داشته باشید
nan s در داده های ورودی مقادیر گمشده را نشان می دهد. تخمین از حذف لیست برای حذف تمام زمان نمونه برداری شده (ردیف) در داده های ورودی حاوی حداقل یک مقدار گمشده استفاده می کند. به طور خاص ، تخمین این مراحل را انجام می دهد:
هماهنگ سازی یا ادغام ، مجموعه داده های PRESAMPLE E0 ، V0 و Y0 و داده های نمونه موثر X و Y را برای ایجاد مجموعه های جداگانه PRESAMPLE و ENTBERIVESAMPES ایجاد می کند.
تمام ردیف ها را از نمونه و نمونه های تأثیرگذار حاوی حداقل یک نان حذف کنید.
حذف لیست ، اندازه نمونه را کاهش می دهد و می تواند سری زمانی نامنظم ایجاد کند.< Pan> مثال: برای یک مدل با واریانس ثابت ، "واریانس 0" ، 2 را تنظیم کنید تا یک برآورد واریانس اولیه 2 را مشخص کنید.
فارکس بازار مدرن...
ما را در سایت فارکس بازار مدرن دنبال می کنید
برچسب :
نویسنده : امین زندگانی
بازدید : <-PostHit->
آرشیو مطالب
خبرنامه
